Der Button, der alles erklärt
In einem Transportmanagementsystem, das ich in den vergangenen Monaten mit zwei KI-Agenten gebaut habe, gibt es einen unscheinbaren Button: „KI-Vorschlag erklären“. Eine Disponentin sieht einen Vorgang (ein Schwertransport, eine Genehmigung, ein Zeitfenster), und das System empfiehlt ihr den nächsten Schritt. Klickt sie auf den Button, formuliert eine KI in zwei, drei Sätzen, warum dieser Schritt jetzt dran ist.
Die meisten Menschen, denen ich das zeige, glauben, sie hätten gerade eine KI beim Entscheiden beobachtet.
Das Gegenteil ist der Fall. Die Entscheidung war längst gefallen, bevor das Sprachmodell auch nur angefragt wurde. Getroffen hat sie Code. Bewertungsregeln fassen Datenqualität, Engpässe, Risiko und Dringlichkeit in Zahlen. Ein Regelwerk leitet aus diesen Zahlen eine Aktion ab. Ein Freigabe-Gate prüft, ob diese Aktion automatisch laufen darf oder einen Menschen braucht. Jeder dieser Schritte ist deterministisch: Gleiche Daten ergeben immer dieselbe Entscheidung. Und jeder lässt sich prüfen, denn das System protokolliert, welche Evidenz zu welchem Score und welcher Score zu welcher Empfehlung führte.
Das Sprachmodell kommt erst danach ins Spiel, mit einem einzigen Auftrag: Erkläre einem Menschen in verständlicher Sprache, was hier entschieden wurde. Fällt das Modell aus, springt eine schlichte Textschablone ein. Das System läuft weiter, weniger eloquent, aber keinen Deut weniger richtig.
Diesen Grundsatz habe ich in beiden Systemen, die ich dieses Jahr mit KI-Agenten gebaut habe, als Architecture Decision Record festgeschrieben: Das LLM darf interpretieren, formulieren und erklären. Es darf nicht frei über Prozessschritte, Blocker, Beträge oder Go/No-Go entscheiden.
Dieses Whitepaper zeigt, wie diese Architektur von innen aussieht, mit den Regeln, Schwellenwerten und Codeauszügen aus dem Produktivsystem. Sie müssen den Code nicht lesen. Aber Sie sollen sehen, dass „vertrauenswürdige KI“ eine Bauweise ist. Compliance-Prosa allein erzeugt sie nicht.
Die Angst ist berechtigt. Die Antwort ist falsch.
Ich habe in den letzten Monaten mit vielen Führungskräften über KI gesprochen. Die Frage hinter fast allen Gesprächen ist selten technisch. Sie lautet: Wer ist verantwortlich, wenn die KI etwas Falsches tut?
Diese Angst ist berechtigt. Sprachmodelle sind probabilistisch. Dasselbe Modell kann auf dieselbe Frage heute so und morgen anders antworten. Wer einem solchen System eine Kreditfreigabe, eine Disposition oder auch nur den automatischen Versand einer E-Mail überlässt, hat ein Zurechenbarkeitsproblem: Die Entscheidung lässt sich weder reproduzieren noch prüfen. Weder eine Wirtschaftsprüferin noch ein Betriebsrat wird das akzeptieren, und zwar zu Recht.
Die übliche Antwort auf diese Angst ist die falsche. Organisationen stoppen ihre KI-Projekte oder sperren sie in Pilotumgebungen, in denen sie nie etwas Echtes tun dürfen. Ich nenne das das Piloten-Fegefeuer. Die Zahlen dazu sind ernüchternd, auch wenn man sie mit Vorsicht liest. Die MIT-Initiative NANDA fand 2025, dass 95 Prozent der untersuchten Organisationen aus ihren Generative-AI-Projekten keinen messbaren Ertrag ziehen, wobei die Autoren selbst darauf hinweisen, dass sich das auf ihre Stichprobe von 52 Organisationen bezieht (MIT NANDA 2025). Die RAND Corporation verweist auf Schätzungen, nach denen mehr als 80 Prozent aller KI-Projekte scheitern, doppelt so viele wie bei IT-Projekten ohne KI (Ryseff, De Bruhl und Newberry 2024). Gartner meldet im Januar 2026, mindestens die Hälfte der GenAI-Projekte sei nach dem Proof of Concept abgebrochen worden; 2024 hatte die Prognose noch bei 30 Prozent gelegen (Gartner 2024, 2026). Man hat dann formal ein KI-Projekt gehabt, aber kein Risiko und auch keinen Nutzen. Der Vorstand sagt am Ende den Satz, den ich nicht mehr hören kann: „Wir haben KI ausprobiert, das hat bei uns nicht funktioniert.“
Hinzu kommt die Regulierung, und dort hat sich seit dem Sommer etwas verschoben. Lange galt der 2. August 2026 als der Tag, an dem der EU AI Act die Pflichten für Hochrisiko-Systeme scharfstellt. Daraus wurde nichts. Die Verordnung (EU) 2026/1744, das „Digital Omnibus“ für KI, ist am 24. Juli 2026 im Amtsblatt erschienen und am 27. Juli in Kraft getreten. Sie verschiebt die Hochrisiko-Pflichten für eigenständige Systeme nach Anhang III auf den 2. Dezember 2027 und für KI in regulierten Produkten nach Anhang I auf den 2. August 2028 (Europäische Union 2026). Der Kern der Anforderungen bleibt: technische Dokumentation (Artikel 11), Aufzeichnung der Vorgänge (Artikel 12) und wirksame menschliche Aufsicht (Artikel 14). Verstöße gegen Anbieter- und Betreiberpflichten kann Artikel 99 mit bis zu 15 Millionen Euro oder 3 Prozent des weltweiten Jahresumsatzes ahnden, je nachdem, welcher Betrag höher ist; für kleine und mittlere Unternehmen gilt der niedrigere.
Nicht jedes KI-System fällt in die Hochrisiko-Klasse, und der Aufschub ändert die Richtung nicht. Ich erwarte, dass Prüfer und Aufsichtsräte ihre Maßstäbe schon jetzt daran ausrichten, auch unterhalb der Schwelle. Wer Entscheidungen protokolliert, erklärbar hält und an der richtigen Stelle einen Menschen verlangt, muss später wenig umbauen.
Es gibt eine bessere Antwort. Sie ist eine Architekturentscheidung: Trennen Sie Breite von Entscheidung.
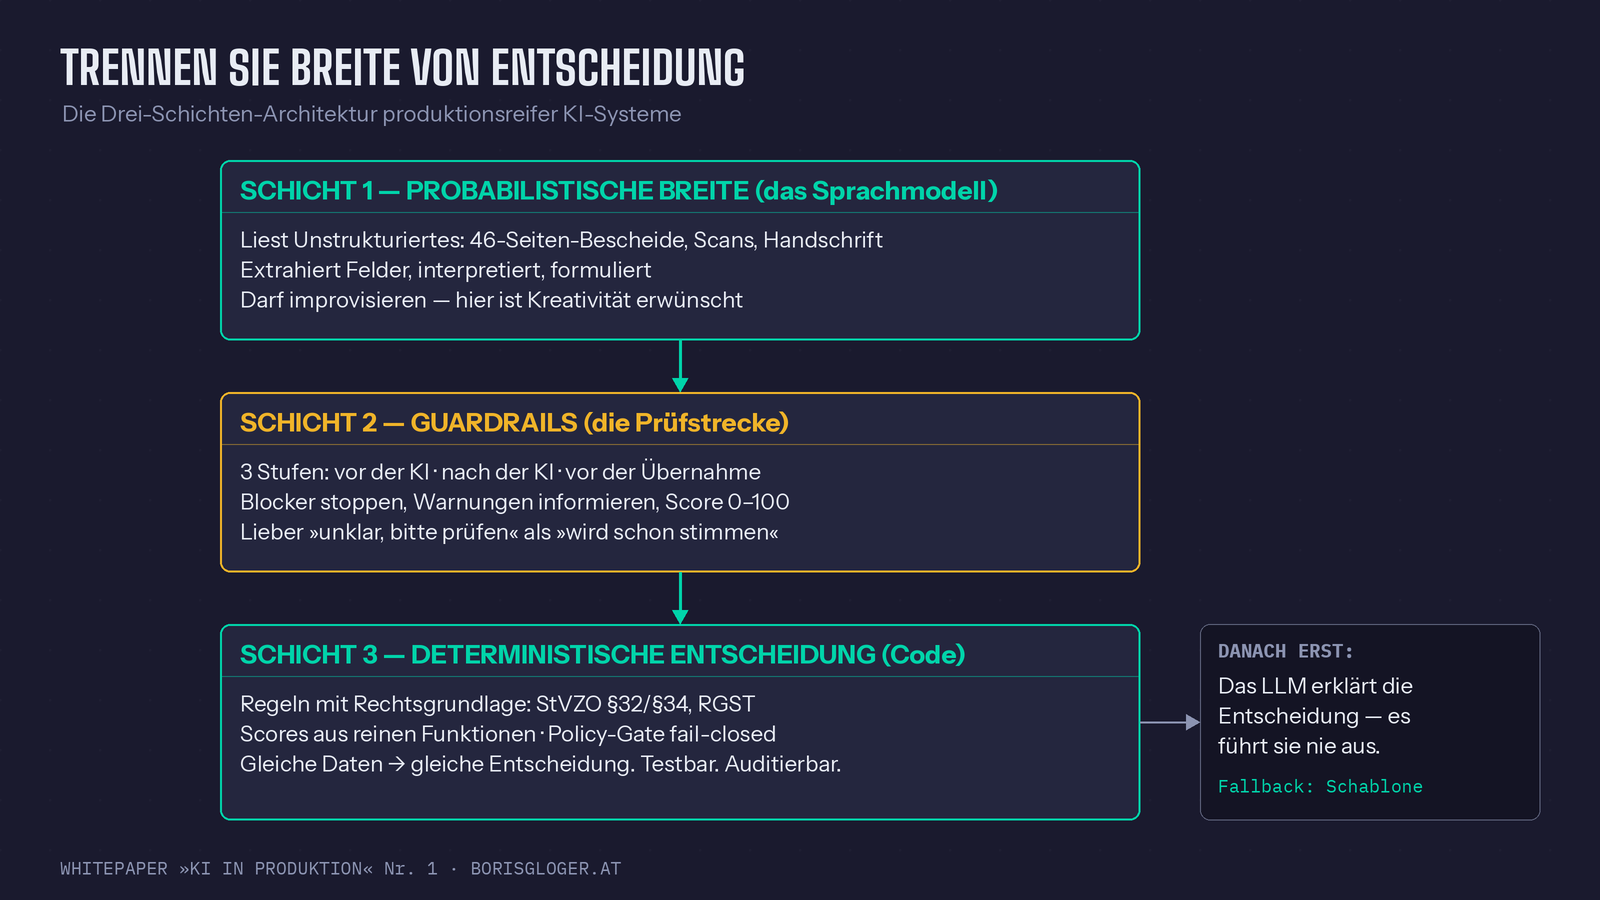
Das Pattern: Zwei Jobs, zwei Werkzeuge
Ein Sprachmodell ist außerordentlich gut darin, Unstrukturiertes in Struktur zu verwandeln. In meinem Transportsystem liest es 46-seitige behördliche Genehmigungsbescheide, voller Auflagen, Brückenlasten und Fahrverbote, in Behördendeutsch, teils gescannt, und macht daraus in etwa einer Minute strukturierte Daten. Kein klassisches Programm könnte das leisten. Dafür ist das Modell da. Das ist sein Job: Breite.
Was aus diesen Daten folgt, entscheidet das Modell nicht. Ob ein Transport ein Begleitfahrzeug braucht, legt eine Regel fest, die Rechtsnormen in Code fasst. Die vollständige Schwellenwert-Tabelle des Systems passt auf eine halbe Seite, und genau das ist ihre Stärke. Die Straßenverkehrs-Zulassungs-Ordnung setzt die Grenzen, ab denen ein Transport zum Großraum- und Schwertransport wird: 2,55 Meter Breite (§ 32 Abs. 1 StVZO), 4,00 Meter Höhe (§ 32 Abs. 2), 16,50 Meter Länge für den Sattelzug (§ 32 Abs. 4), 10 Tonnen je Einzelachse (§ 34 Abs. 4) und 40 Tonnen Gesamtmasse für Fahrzeugkombinationen mit mehr als vier Achsen (§ 34 Abs. 6). Darüber liegen die Schwellen aus den Richtlinien für Großraum- und Schwertransporte, die das System ebenfalls hinterlegt hat: Begleitfahrzeug BF3 ab 3,00 Meter Breite, BF4 ab 3,50 Meter, Polizeibegleitung ab 4,50 Meter und eine gesonderte Brückenprüfung ab 80 Tonnen Gesamtmasse. Diese Richtlinien beschreiben den Regelfall; im Einzelfall kann die Behörde im Bescheid anders auflegen.
Jede dieser Regeln kostet null Cent pro Anfrage, antwortet in unter einer Millisekunde und rechnet jedes Mal gleich. Falsch wird sie nur, wenn das Gesetz sich ändert oder wenn wir es falsch abgeschrieben haben. Gegen die erste Gefahr gibt es einen täglichen Prüfjob: Er gleicht die einschlägigen Gesetzestexte ab, extrahiert ausschließlich wörtliche Zahlenwerte und legt jede Abweichung einem Menschen als Review-Item vor, statt sie automatisch zu übernehmen. Kostenpunkt dieser permanenten Rechtsüberwachung: rund drei Dollar im Monat.
Das ist die erste Lektion aus dem Maschinenraum: Das Teuerste an KI ist, sie für Dinge zu benutzen, die Code besser kann. Ein Sprachmodell, das bei jeder Anfrage neu „überlegt“, ob 3,85 Meter Breite ein Begleitfahrzeug erfordern, verschwendet Intelligenz. Es ist teurer und unzuverlässiger als eine if-Abfrage mit Paragraphen-Kommentar.
Der Maschinenraum, Schicht 1: Guardrails um jede Extraktion
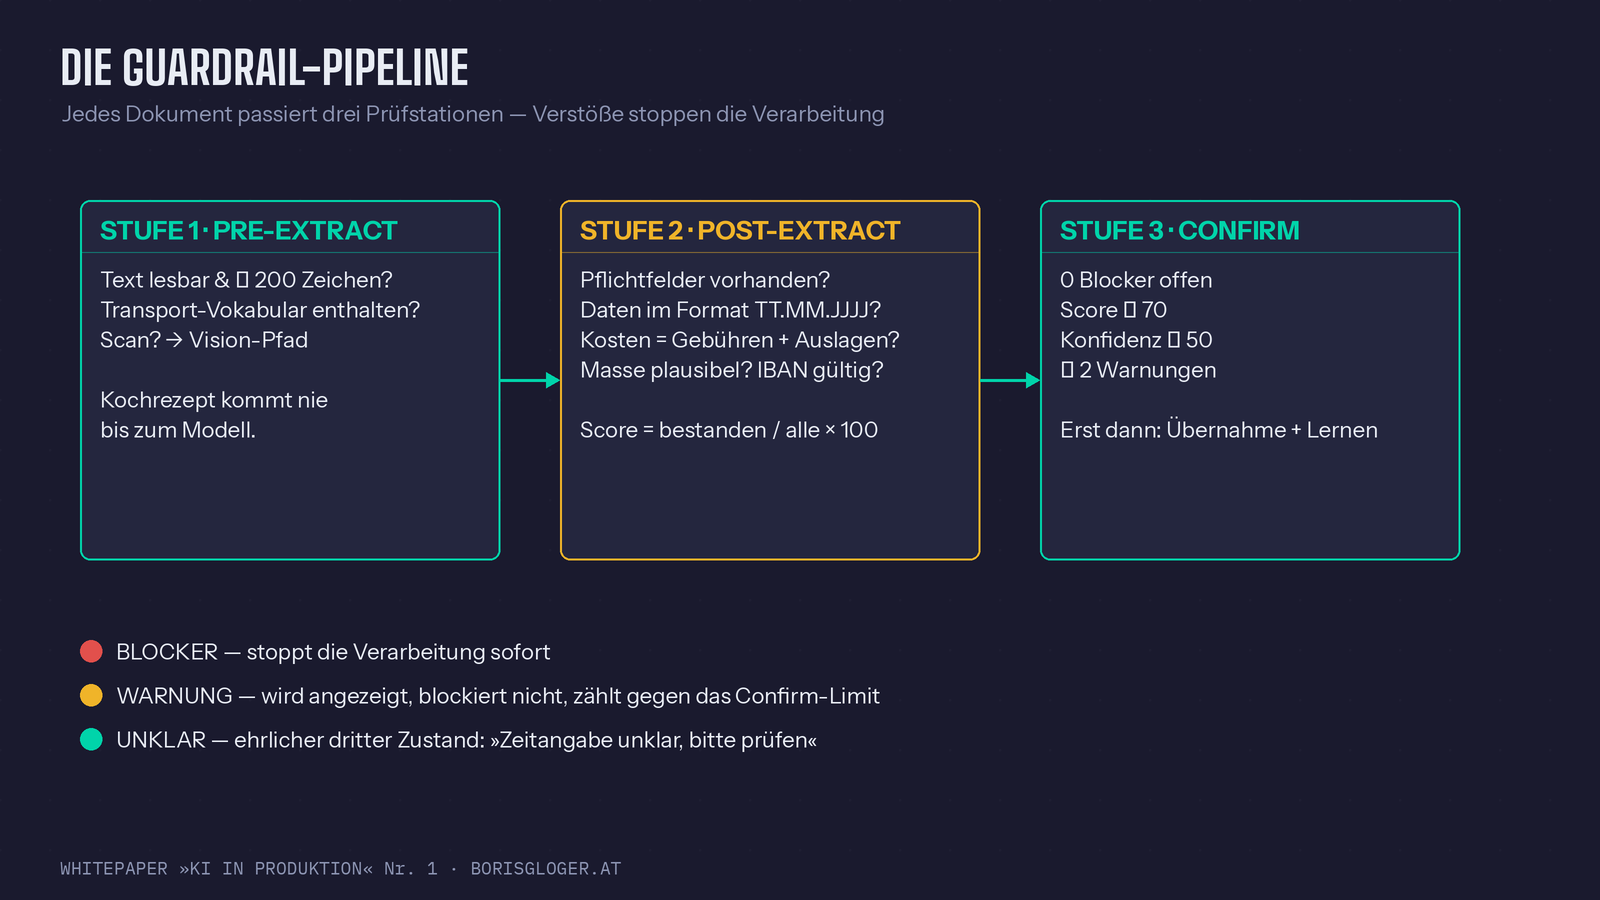
Zwischen probabilistischer Breite und deterministischer Entscheidung sitzt eine Prüfstrecke. Jedes Dokument, das durch das System läuft, passiert drei Stationen.
Stufe 1, vor der KI (Pre-Extract). Ist der Text lesbar und lang genug (Minimum: 200 Zeichen)? Enthält er überhaupt Transport-Vokabular? Ein versehentlich hochgeladenes Kochrezept kommt gar nicht erst bis zum Modell. Fällt ein Scan unter die Textschwelle, wechselt die Pipeline automatisch auf einen Vision-Pfad: Das PDF wird in Bilder zerlegt und von einem Bildmodell gelesen, mit denselben nachgelagerten Prüfungen.
Stufe 2, nach der KI (Post-Extract). Hier wird das Modell kontrolliert wie ein neuer Mitarbeiter in der Probezeit. Die Checks hängen vom Dokumenttyp ab. Bei einem Genehmigungsbescheid fragt das System: Sind Bescheidnummer, Antragsteller und Behörde vorhanden? Liegt der Gültigkeitsbeginn vor dem Gültigkeitsende? Ergeben Gebühren plus Auslagen die Gesamtkosten, auf den Cent? Ist die Gesamtmasse größer als die Masse der Ladung allein? Bei einem Frachtauftrag prüft es, ob das IBAN-Format stimmt, der Ladetermin vor dem Eintrefftermin liegt und der Frachtpreis positiv ist. Jeder Check ist entweder Blocker (stoppt die Verarbeitung) oder Warnung (wird angezeigt, blockiert nicht). Aus dem Verhältnis bestandener zu allen Checks entsteht ein Score von 0 bis 100.
Stufe 3, vor der Übernahme (Confirm). Erst wenn null Blocker offen sind, der Score mindestens 70 erreicht, die Konfidenz des Modells mindestens 50 beträgt und höchstens zwei Warnungen offen sind, darf eine Extraktion bestätigt und ins System übernommen werden.
Das Prinzip hinter allen drei Stufen: Das System sagt lieber „das weiß ich nicht sicher“ als „wird schon stimmen“. In der Fahrer-Ansicht gibt es dafür einen eigenen Zustand. Die Fahrzeiten-Ampel kennt neben Grün und Rot auch Gelb: „Zeitangabe unklar“. Ein System, das bei fehlenden Daten „nicht erlaubt“ anzeigt, ist falsch vorsichtig. Eines, das „erlaubt“ anzeigt, ist gefährlich. Die ehrliche Antwort lautet manchmal: unklar, bitte prüfen. Auch diese Entscheidung trifft Code, nie das Modell.
Auch die Formfehler des Modells repariert kein Modell. Eine kleine Zustandsmaschine korrigiert unmaskierte Anführungszeichen im gelieferten JSON, entfernt Steuerzeichen und fordert abgeschnittene Antworten neu an, höchstens zweimal. Danach gibt es einen sauberen Fehler statt eines stillen Defekts. Das ist der Unterschied zwischen einem Prompt und einer Pipeline.
Der Maschinenraum, Schicht 2: Die Entscheidungs-Engine
Jetzt der Teil, der in den meisten KI-Projekten fehlt. Wenn ein Vorgang im System liegt (Bescheid extrahiert, Kunde zugeordnet, Kran angefragt), stellt sich die operative Frage: Was ist jetzt der nächste Schritt? Genau hier setzen die meisten Projekte das Sprachmodell ein. Genau hier darf es nicht sitzen.
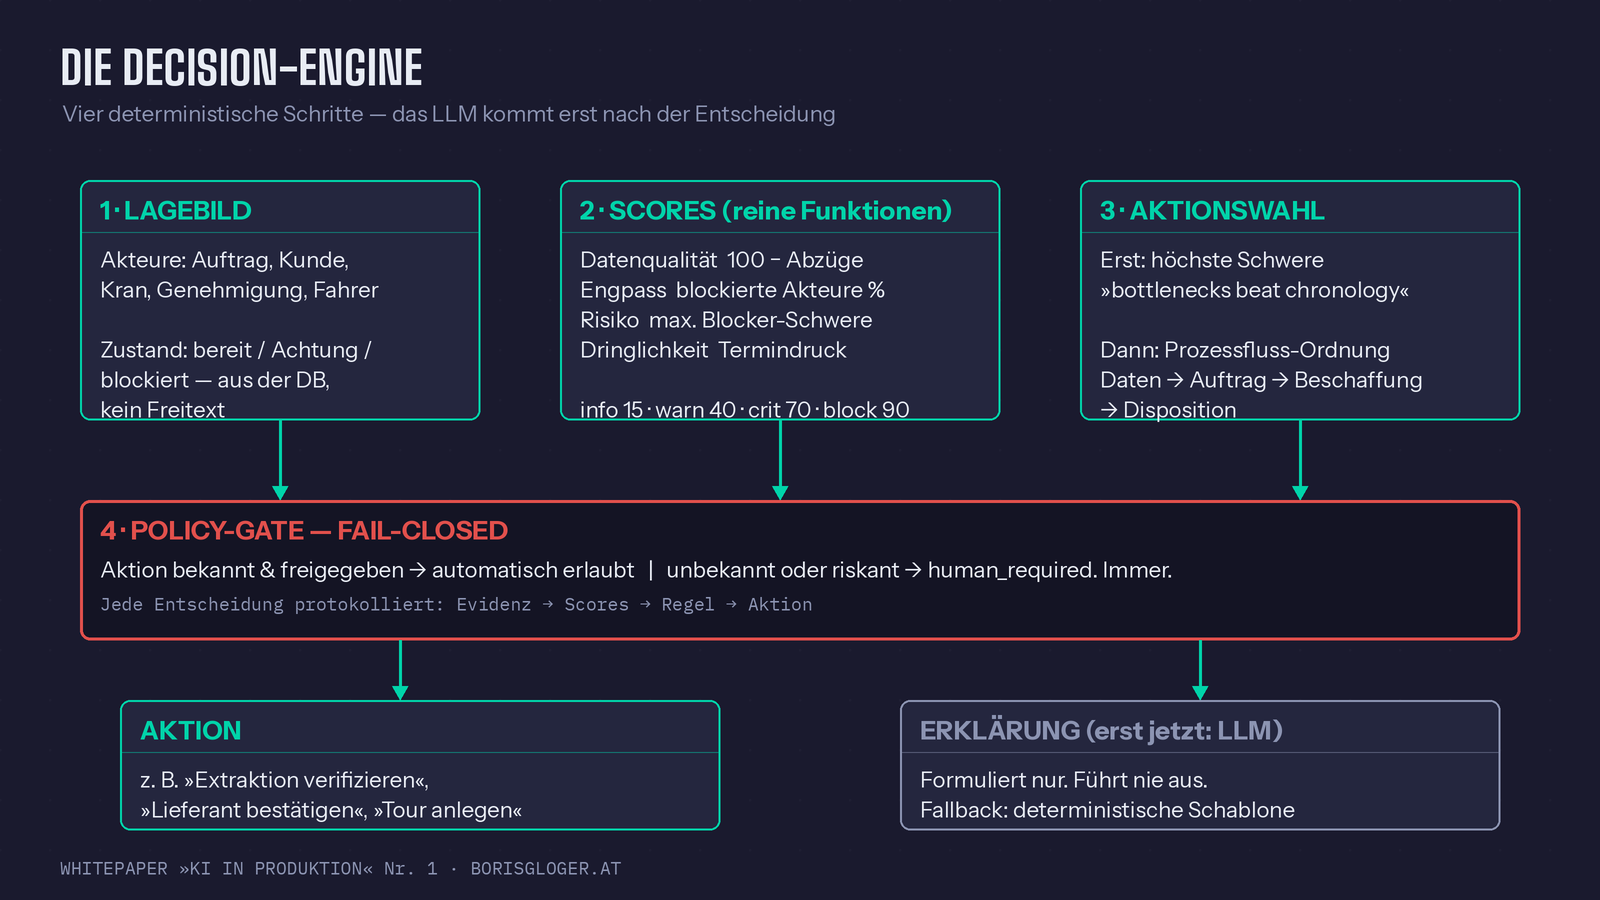
In meinem System beantwortet diese Frage eine Decision-Engine in vier deterministischen Schritten.
Schritt 1, Lagebild aus strukturierten Daten. Jeder Beteiligte des Vorgangs (Auftrag, Kunde, Kran, Genehmigung, Fahrer, Abrechnung) wird als Akteur mit Zustand projiziert: bereit, braucht Aufmerksamkeit, blockiert. Jeder Blocker hat einen Code und eine Schwere: info, warning, critical, blocking. Das ist eine Projektion aus Datenbankzuständen, ohne Freitext und ohne Interpretation.
Schritt 2, Scores aus harten Regeln. Vier Kennzahlen, jede eine reine Funktion ohne Seiteneffekte, vollständig testbar. Drei davon im echten Code:
```typescript // Risiko: höchste Blocker-Severity über alle Akteure. const SEVERITY_RISK: Record<BlockerSeverity, number> = { info: 15, warning: 40, critical: 70, blocking: 90, };
// Datenqualität: 100 minus feste Abzüge je Datenlücken-Blocker. const DATA_QUALITY_PENALTY: Record<string, number> = { "permit.low_guardrail_score": 30, "permit.extraction_warnings": 15, "customer.unknown": 15, "crane.spec_missing": 15, "customer.no_contact": 10, };
// Engpass: Anteil blockierter (voll) und // aufmerksamkeitsbedürftiger (halb) Akteure. export function scoreBottleneck(board: ActorBoard): number { const actors = nonCaseActors(board); if (actors.length === 0) return 0; const blocked = actors.filter((a) => a.readiness === "blocked").length; const attention = actors.filter((a) => a.readiness === "attention").length; return clamp((100 (blocked + 0.5 attention)) / actors.length); } ```
Man muss diesen Code nicht lesen können, um das Entscheidende zu sehen: Es sind Zahlen, die jemand festgelegt hat. Warum kostet ein unbekannter Kunde 15 Punkte Datenqualität und ein fehlender Kontakt nur 10? Darüber kann man streiten, in einem Review, mit Blick auf die Zeile. Genau das ist der Punkt. Bei einem Modellgewicht geht das nicht.
Schritt 3, Aktionswahl nach zwei Prinzipien. Die Engine wählt die nächste Aktion zuerst nach der höchsten Blocker-Schwere („bottlenecks beat chronology“: Der schlimmste Engpass schlägt die zeitliche Reihenfolge). Danach gilt die Ordnung des Prozessflusses: Datenqualität vor Auftrag, Auftrag vor Beschaffung, Beschaffung vor Disposition („flow beats local optimization“: Eine schnelle spätere Aktion auf wackliger Datenbasis erzeugt nur Nacharbeit). Jede mögliche Aktion ist eine Regel mit Blocker-Code, Aktion und Zielschritt, zusammen eine Tabelle und kein Netz von Gewichten.
Schritt 4, das Freigabe-Gate, fail-closed. Bevor irgendetwas geschieht, prüft die Engine die Freigabe-Policies: Darf diese Aktion automatisch laufen, oder braucht sie einen Menschen? Hier steht die Zeile, die ich für die wichtigste im ganzen System halte: Eine unbekannte oder als riskant markierte Aktion wird eskaliert, niemals ausprobiert. Der Default ist `human_required`. Fail-closed. Das Gegenteil, fail-open, im Zweifel machen, ist der Konstruktionsfehler fast aller KI-Projekte, die ich scheitern sehe.
Erst wenn diese vier Schritte durchlaufen sind und Aktion, Scores, Begründung und Evidenz feststehen, wird das Sprachmodell gerufen, mit dem Auftrag, das Ergebnis in zwei Sätzen zu erklären. Sein Text wird angezeigt, nie ausgeführt. Antwortet das Modell nicht, formuliert eine Schablone. Dasselbe Muster gilt beim Fahrer-Briefing: Tour, Stopps, Risiken und Auflagen werden deterministisch gesammelt, das Modell macht daraus lesbares Deutsch, und fällt es aus, bekommt die Fahrerin oder der Fahrer die Schablonen-Version. Die Information ist dieselbe.
Der Maschinenraum, Schicht 3: Lernen ohne Kontrollverlust
Bleibt die Frage, wie ein so streng eingezäuntes System besser wird. Die Antwort kommt ganz ohne Fine-Tuning aus: Jede von einem Menschen bestätigte Extraktion wird zum Lernbeispiel.
Klickt die Disponentin „Extraktion korrekt“, wird das Paar aus Dokument und geprüftem Ergebnis gespeichert. Bei der nächsten Extraktion desselben Dokumenttyps wählt das System die ähnlichsten bestätigten Beispiele aus, per Embedding-Vergleich, höchstens fünf, und gibt sie dem Modell als Muster mit. Die Trefferquote steigt mit jedem Arbeitstag, ohne dass je ein Modell trainiert wurde.
Entscheidend ist die Governance-Eigenschaft dieser Lernschleife: Gelernt wird nur, was ein Mensch bestätigt hat, und bestätigen lässt sich nur, was die Guardrails passiert hat. Die Confirm-Stufe aus Schicht 1 ist zugleich das Qualitätstor der Lernschleife. Ein System, das aus unbestätigten eigenen Ausgaben lernt, verstärkt seine Fehler. Dieses System kann das architektonisch nicht.
Technisch flankiert wird das von Prompt-Caching. Die stabilen Teile des Auftrags, Schema und Beispiele, liegen im Cache des Modellanbieters. Innerhalb der Cache-Laufzeit werden sie ab dem zweiten Dokument zu einem Bruchteil des Preises gelesen, und die Antwortzeit sinkt.
„Aber dann kann die KI ja nichts Neues“
Diesen Einwand höre ich regelmäßig. Er enthält ein Missverständnis über den Ort von Kreativität in produktiven Systemen.
Die generative Leistung des Modells findet dort statt, wo Unstrukturiertes gedeutet wird. Ein gescannter Bescheid mit handschriftlichen Anmerkungen, ein Auftrag mit widersprüchlichen Angaben, ein Dokument, das es in dieser Form noch nie gab: Hier improvisiert das Modell, und hier soll es das. Was aus dem Ergebnis folgt, ist kein Ort für Improvisation. Niemand wünscht sich einen kreativen Buchhalter.
Der zweite Einwand wiegt schwerer, denn der Markt bewegt sich gerade in die Gegenrichtung. „Agentische KI“, autonome Agenten, die selbstständig Prozesse durchlaufen: Das ist das Versprechen der Stunde, und ich baue selbst täglich mit solchen Agenten. Im Hype geht eine Unterscheidung verloren: Autonomie in der Erarbeitung ist etwas anderes als Autonomie in der Entscheidung. Meine Entwicklungs-Agenten arbeiten stundenlang selbstständig, aber gegen ein Quality-Gate, das jeden Commit prüft (Typprüfung, statische Analyse, mehr als 2.300 Tests), und gegen Standards, die ein Mensch gesetzt hat. Dasselbe Muster, eine Ebene höher: Autonomie im Wie, niemals im Ob.
Der dritte Einwand ist der technischste: „Dann ist das ja ein Expertensystem mit LLM-Anstrich.“ Fast. Der Unterschied zu den Expertensystemen der Achtziger liegt darin, dass die teuerste Zutat, das Verstehen unstrukturierter Wirklichkeit, heute das Modell liefert. Die Regelschicht ist dünn, weil sie nur noch entscheiden muss. Das Verstehen liefert das Modell. Das Expertensystem scheiterte daran, die Welt in Regeln zu fassen. Diese Architektur fasst nur die Entscheidungen in Regeln, und das ist bei den meisten Geschäftsprozessen eine Tabelle von überschaubarer Länge.
Was es kostet, dieses Pattern nicht zu haben
Rechnen wir konservativ. Ein mittelständisches Unternehmen startet ein KI-Projekt: acht Personen, achtzehn Monate, externe Unterstützung, schnell ist eine bis anderthalb Millionen Euro erreicht. Das Projekt liefert einen Piloten, der beeindruckend demonstriert. Dann kommt die Frage nach der Produktivsetzung und mit ihr die Governance-Frage. Niemand kann sie beantworten, weil das System von Grund auf so gebaut ist, dass das Modell überall mitentscheidet. Nachrüsten lässt sich das kaum: Determinismus ist eine Architekturentscheidung, die am Anfang fällt. Zu den Abbruchgründen, die Gartner nennt, gehören unzureichende Risikokontrollen, steigende Kosten und unklarer Geschäftswert. Das liest sich wie die Checkliste genau dieses Musters.
Zum versenkten Budget kommen achtzehn Monate, in denen die Organisation gelernt hat, dass KI bei ihr „nicht funktioniert“, während der Wettbewerber, der die Trennung von Anfang an eingezogen hat, längst produktiv ist. Meine beiden Systeme dieses Jahres, das Transportsystem und ein CRM für eine NGO, das im Sommer in den Echtbetrieb gegangen ist, haben zusammen einen Bruchteil davon gekostet. Beide lassen sich mit derselben Frage regieren: Zeig mir, welche Regel entschieden hat.
Die fünf Fragen
Sie müssen kein Entwickler sein, um dieses Pattern einzufordern. Sie brauchen fünf Fragen und die Bereitschaft, bei ausweichenden Antworten nachzuhaken.
Frage 1: Wo genau entscheidet das Modell? Lassen Sie sich die Stellen zeigen, an denen die KI-Ausgabe direkt eine Aktion auslöst, einen Status ändert oder einen Betrag bestimmt. Jede dieser Stellen ist ein Governance-Risiko. Die richtige Antwort enthält den Satz: „Das Modell schlägt vor, die Entscheidung trifft die Regel-Schicht.“
Frage 2: Was passiert, wenn das Modell ausfällt oder Unsinn liefert? Die richtige Antwort beschreibt Fallbacks und Guardrails: Schablonen statt Schweigen, Reparatur-Logik statt Hoffnung. Die falsche Antwort lautet: „Das kommt praktisch nicht vor.“
Frage 3: Ist jede Entscheidung reproduzierbar und auditierbar? Gleiche Daten, gleiche Entscheidung: ja oder nein? Und kann Ihnen das System für eine Entscheidung von vor drei Wochen zeigen, welche Evidenz, welche Scores und welche Regel ihr zugrunde lagen?
Frage 4: Was ist der Default bei Unbekanntem, fail-open oder fail-closed? Wenn das System eine Situation nicht kennt: Handelt es, oder eskaliert es an einen Menschen? Es gibt genau eine richtige Antwort.
Frage 5: Wer hat den Qualitätsmaßstab gesetzt, und wo steht er? Guardrail-Schwellen, Score-Gewichte, Freigaberegeln: Sind das bewusste, dokumentierte, von Menschen verantwortete Entscheidungen, nachlesbar und mit Begründung? Oder sind es Zufallsprodukte des Entwicklungsprozesses? Fragen Sie konkret: „Zeigen Sie mir das Dokument, in dem steht, warum die Schwelle bei 70 liegt.“
Wenn Ihr KI-Projekt diese fünf Fragen souverän beantwortet, haben Sie vermutlich ein System, das produktiv gehen kann. Wenn nicht, haben Sie eine Demo.
Ich baue solche Systeme gemeinsam mit Führungsteams
Die beiden Systeme, über die dieses Whitepaper berichtet, habe ich nicht programmiert. Ich habe ein Team aus KI-Agenten geführt, wie ein Product Owner ein Scrum-Team führt: Prioritäten, Reviews, Standards, Stopps. Wie das geht, habe ich öffentlich dokumentiert. Dass es geht, können Sie sich ansehen, eines der Systeme läuft öffentlich.
Genau das biete ich Führungsteams an: vier bis sechs Wochen, ein echter Prozess aus Ihrem Unternehmen, ein produktionsreifes Ergebnis. Ihr Führungsteam sitzt dabei im Ring und lernt, worauf es in den nächsten Jahren ankommt: Breite von Reife zu unterscheiden und Qualität von Systemen zu verlangen, deren Code man nicht selbst liest. Für den schnelleren Einstieg gibt es die Executive Build Week: drei bis fünf Tage, Ihr Team, meine Agenten, eine echte Anwendung, Demo-Day am Ende.
Wenn Sie wissen wollen, ob sich Ihr Prozess eignet: [email protected]
Boris Gloger führt seit 25 Jahren Produktentwicklungen, seit 2026 mit Teams aus KI-Agenten. Die Fallstudie zur Methode: [borisgloger.at/ki-als-scrum-team-fuehren](https://borisgloger.at/ki-als-scrum-team-fuehren). Whitepaper 2 dieser Reihe: „Der Maßstab als Dokument: Wie man von einer Maschine Weltklasse-Arbeit verlangt.“
Quellen
- Europäische Kommission (2026): AI Omnibus enters into force. https://digital-strategy.ec.europa.eu/en/news/ai-omnibus-enters-force
- Europäische Union (2026): Verordnung (EU) 2026/1744 des Europäischen Parlaments und des Rates vom 8. Juli 2026 zur Änderung der Verordnungen (EU) 2024/1689, (EU) 2018/1139 und (EU) 2023/1230 (Digital Omnibus on AI), Amtsblatt vom 24. Juli 2026. https://eur-lex.europa.eu/eli/reg/2026/1744/oj
- Europäische Union (2024): Verordnung (EU) 2024/1689 (KI-Verordnung), Artikel 11, 12, 14 und 99, Anhang III. Lesefassung: https://artificialintelligenceact.eu/article/99/
- Gartner (2024): Gartner Predicts 30% of Generative AI Projects Will Be Abandoned After Proof of Concept By End of 2025, 29. Juli 2024. https://www.gartner.com/en/newsroom/press-releases/2024-07-29-gartner-predicts-30-percent-of-generative-ai-projects-will-be-abandoned-after-proof-of-concept-by-end-of-2025
- Gartner (2026): Why 50% of GenAI Projects Fail (Artikel vom 26. Januar 2026). https://www.gartner.com/en/articles/genai-project-failure
- MIT NANDA (2025): The GenAI Divide: State of AI in Business 2025. Bericht: https://mlq.ai/media/quarterly_decks/v0.1_State_of_AI_in_Business_2025_Report.pdf. Einordnung: Estrada, S. (2025): MIT report: 95% of generative AI pilots at companies are failing, Fortune, 18. August 2025. https://fortune.com/2025/08/18/mit-report-95-percent-generative-ai-pilots-at-companies-failing-cfo/
- Ryseff, J., De Bruhl, B. F. und Newberry, S. J. (2024): The Root Causes of Failure for Artificial Intelligence Projects and How They Can Succeed. RAND Corporation. https://www.rand.org/pubs/research_reports/RRA2680-1.html
- Straßenverkehrs-Zulassungs-Ordnung (StVZO), § 32 (Abmessungen von Fahrzeugen und Fahrzeugkombinationen) und § 34 (Achslast und Gesamtgewicht). https://www.gesetze-im-internet.de/stvzo_2012/__32.html, https://www.gesetze-im-internet.de/stvzo_2012/__34.html
- Richtlinien für Großraum- und Schwertransporte (RGST 2026), Stand 20. November 2025, Notifizierung im TRIS-System der EU-Kommission. https://technical-regulation-information-system.ec.europa.eu/el/notification/27510/text/D/DE
- Anthropic (o. D.): Prompt caching. https://platform.claude.com/docs/en/build-with-claude/prompt-caching
- Codeauszüge und Systemangaben: Produktivsystem vimoki.ai, ADR 0012 „AI-Routing Decision Engine“.